EP02: Virtual Team: Eine KI-Belegschaft mit Review-Gate
Ein Chatfenster beantwortet Fragen. Eine Aufgabe mit mehreren Schritten braucht mehr: Jemand muss sie zerlegen, die Teilschritte in der richtigen Reihenfolge erledigen und am Ende prüfen, ob das Ergebnis taugt. Dafür hat veilSense das Virtual Team gebaut.
Das Virtual Team macht einen Workspace zu einer kleinen Organisation aus KI-Agenten. Die Agenten nehmen Aufgaben von einem gemeinsamen Board, zerlegen sie in Teilschritte, reichen Arbeit untereinander weiter und liefern pro Aufgabe ein Ergebnis. veilSense beschreibt das bewusst nicht als autonomen Bot, sondern als strukturiertes Team mit Rollen, Hierarchie, Board und Regeln, also dem Gerüst, auf dem auch menschliche Teams laufen. Ein Mensch bleibt im Spiel: Jede Aufgabe endet mit einer Prüfung durch einen Menschen.
Agenten mit Rolle, Expertise und Fähigkeiten
Ein Agent ist mehr als ein Modell mit einem Namen. Er hat eine Stellenbeschreibung, einen Expertise-Bereich, der zur Zuordnung dient, und eine Liste freigegebener Fähigkeiten. Dazu gehören die Suche im Brain, der Aufruf eines Assistenten, das Erzeugen eines Dokuments oder ein MCP-Werkzeug. Ein Agent kann außerdem einen Systemprompt mit den Regeln seiner Domäne erhalten, zum Beispiel den Hausstil für ein Angebot.
Die Expertise entscheidet, wer welchen Teilschritt übernimmt: Der Scheduler ordnet jeden bereiten Teilschritt einem freien Agenten mit passender Expertise zu. Verlangt ein Teilschritt eine bestimmte Fähigkeit, wird zusätzlich abgeglichen, ob der Agent sie hat.
Org-Chart: wer führt, wer berichtet
Im Tab „Team“ steht die Organisation als Organigramm. Oben steht der Mensch, der für das Team verantwortlich ist. Darunter sitzen die Agenten, und der Lead koordiniert die Arbeit. Weiterleitung und Eskalation folgen dem Organigramm.
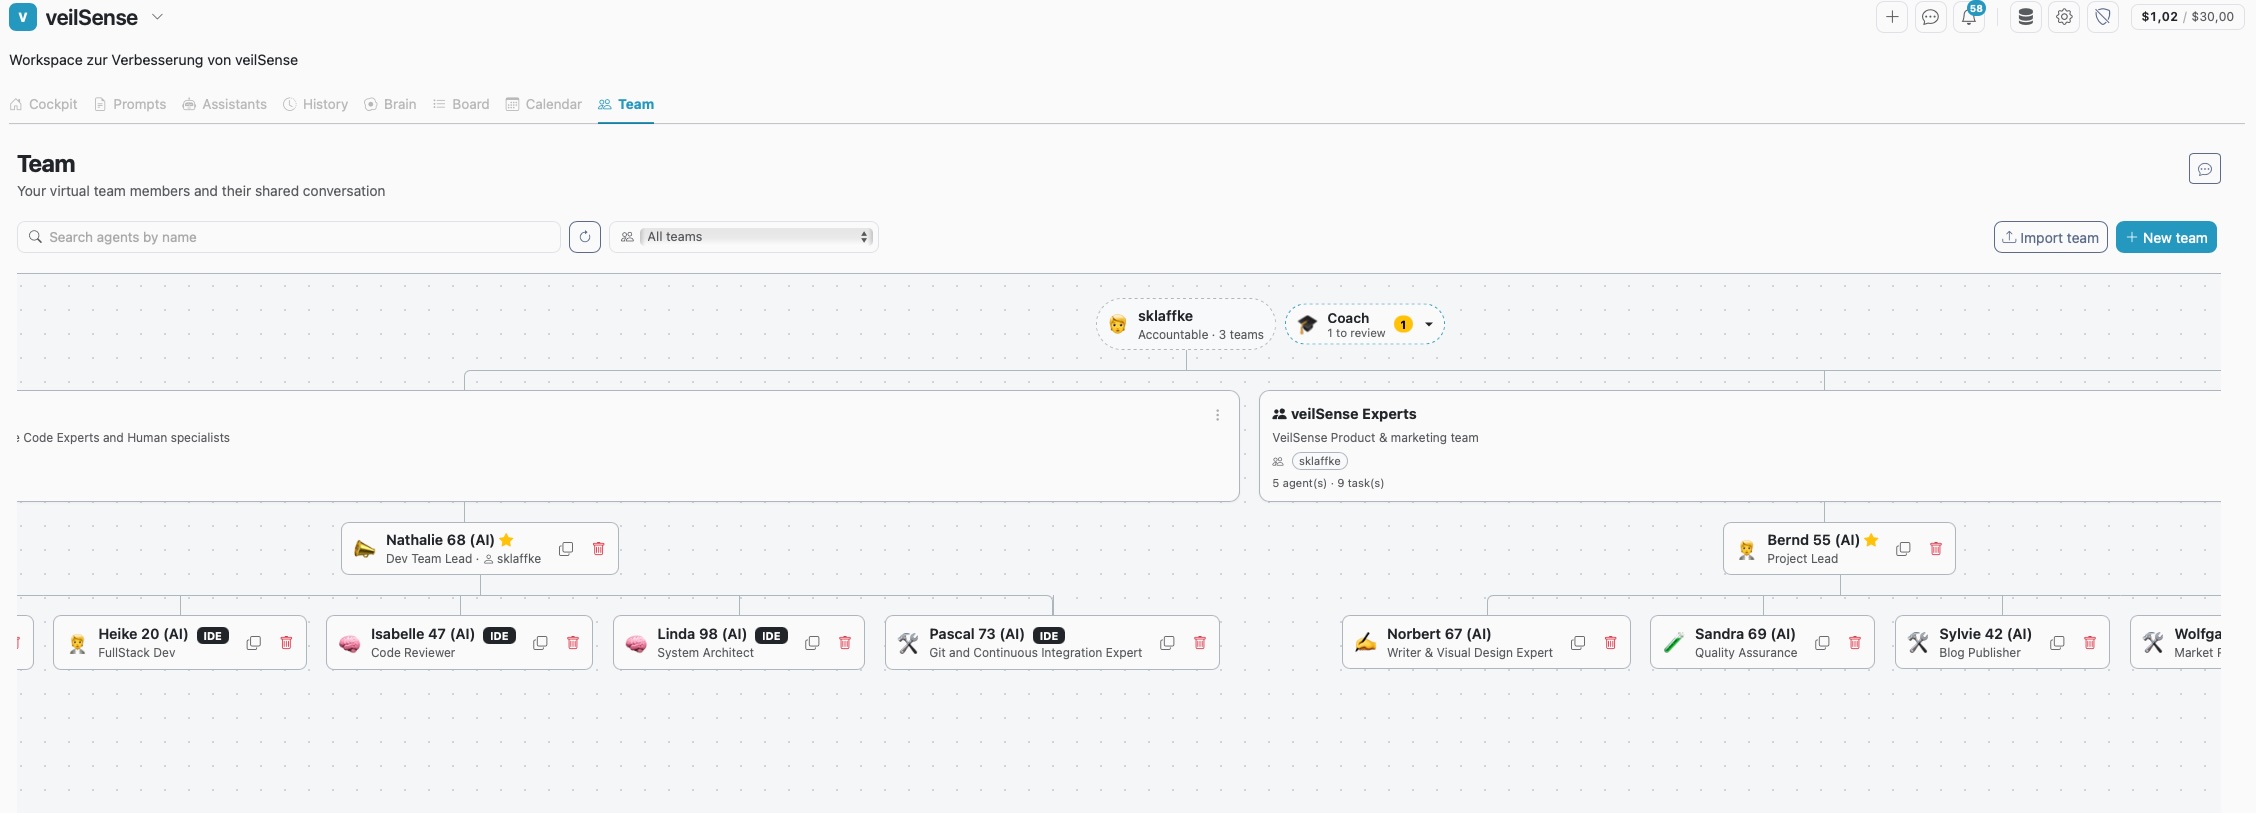
Ein Workspace kann mehrere Teams haben. Jedes Team hat einen eigenen Lead, einen eigenen Chat, eine verantwortliche Person und einen eigenen Satz an Richtlinien. Eine Aufgabe gehört zu genau einem Team, und nur dessen Agenten übernehmen ihre Teilschritte.
Die Arbeitsschleife: zerlegen, freigeben, ausführen, übergeben, prüfen
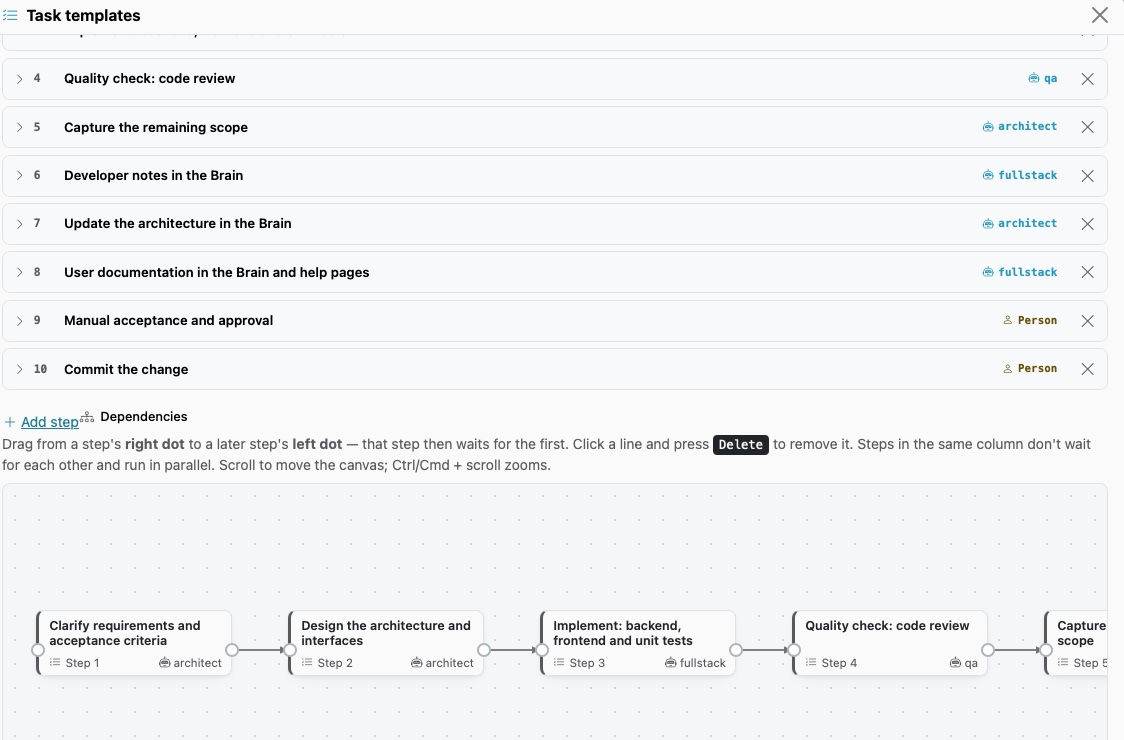
- Zerlegen: Der Lead schlägt eine Zerlegung der Aufgabe vor. Sie ist ein Abhängigkeitsgraph aus Teilschritten, und jeder Teilschritt ist einem Agenten oder einer Person zugewiesen, mit eigenem Chat-Verlauf.
- Freigeben: Nichts läuft, bevor ein Mensch die Zerlegung mit „go“ bestätigt.
- Ausführen: Jeder bereite Teilschritt geht an einen Agenten, dessen Expertise passt. Teilschritte in derselben Spalte laufen parallel, ein Teilschritt mit Vorgänger startet erst, wenn der Vorgänger erledigt ist.
- Übergeben: Ergebnisse wandern entlang der Abhängigkeitskette. Jeder nachgelagerte Schritt sieht das Ergebnis seines Vorgängers und die übrigen Ergebnisse. Alle Schritte einer Aufgabe schreiben in einen gemeinsamen Brain-Eintrag, in dem auch das erzeugte Dokument abgelegt wird.
- Prüfen: Der letzte Schritt fasst zusammen und erzeugt das Ergebnis. Erst die Freigabe durch einen Menschen schließt die Aufgabe ab.
Fehlt etwas, fragen die Agenten zuerst im Team nach
Ein Agent blockiert lieber, als falsch zu antworten. Fehlt ihm eine Information, versucht er zuerst seine eigenen Werkzeuge: die Suche im Brain, einen Assistenten oder einen Dokumentgenerator. Reicht das nicht, fragt er einen Teamkollegen oder den Lead. Danach erst wird eine Person gefragt.
Für die Rückfrage entsteht eine Hilfs-Teilaufgabe. Die wartende Teilaufgabe wird fortgesetzt, sobald die Antwort vorliegt. Eine Hilfs-Teilaufgabe kann selbst nicht weiter delegieren, damit die Kette nicht endlos läuft.
Vorlagen: Zerlegungen wiederverwenden
Eine bewährte Zerlegung lässt sich als Vorlage speichern. Die Vorlage enthält Schritte, Zuständigkeiten, Expertise und Hinweise auf Fähigkeiten. Beim nächsten Mal wird die Zerlegung daraus erzeugt, statt das Sprachmodell jedes Mal neu zerlegen zu lassen. Passt ein Suchbegriff der Vorlage zu Titel oder Beschreibung einer Aufgabe, wird sie automatisch verwendet.
Das Review-Gate
Das Review-Gate ist in den Richtlinien des Teams verankert. Jede Zerlegung endet mit einem Schritt für einen Menschen; die Richtlinie „Always add a final review step“ ist standardmäßig aktiv. Schritte wie Review oder Freigabe gehen an eine Person, auch wenn sie als Agentenschritt markiert sind. Soll Inhalt faktisch belegt sein, lässt sich zusätzlich verlangen, dass jede externe Aussage eine Quelle hat. Breite Fähigkeiten lassen sich im Team über gesperrte Fähigkeitsarten begrenzen.
Der Coach: der Teamkontrolleur
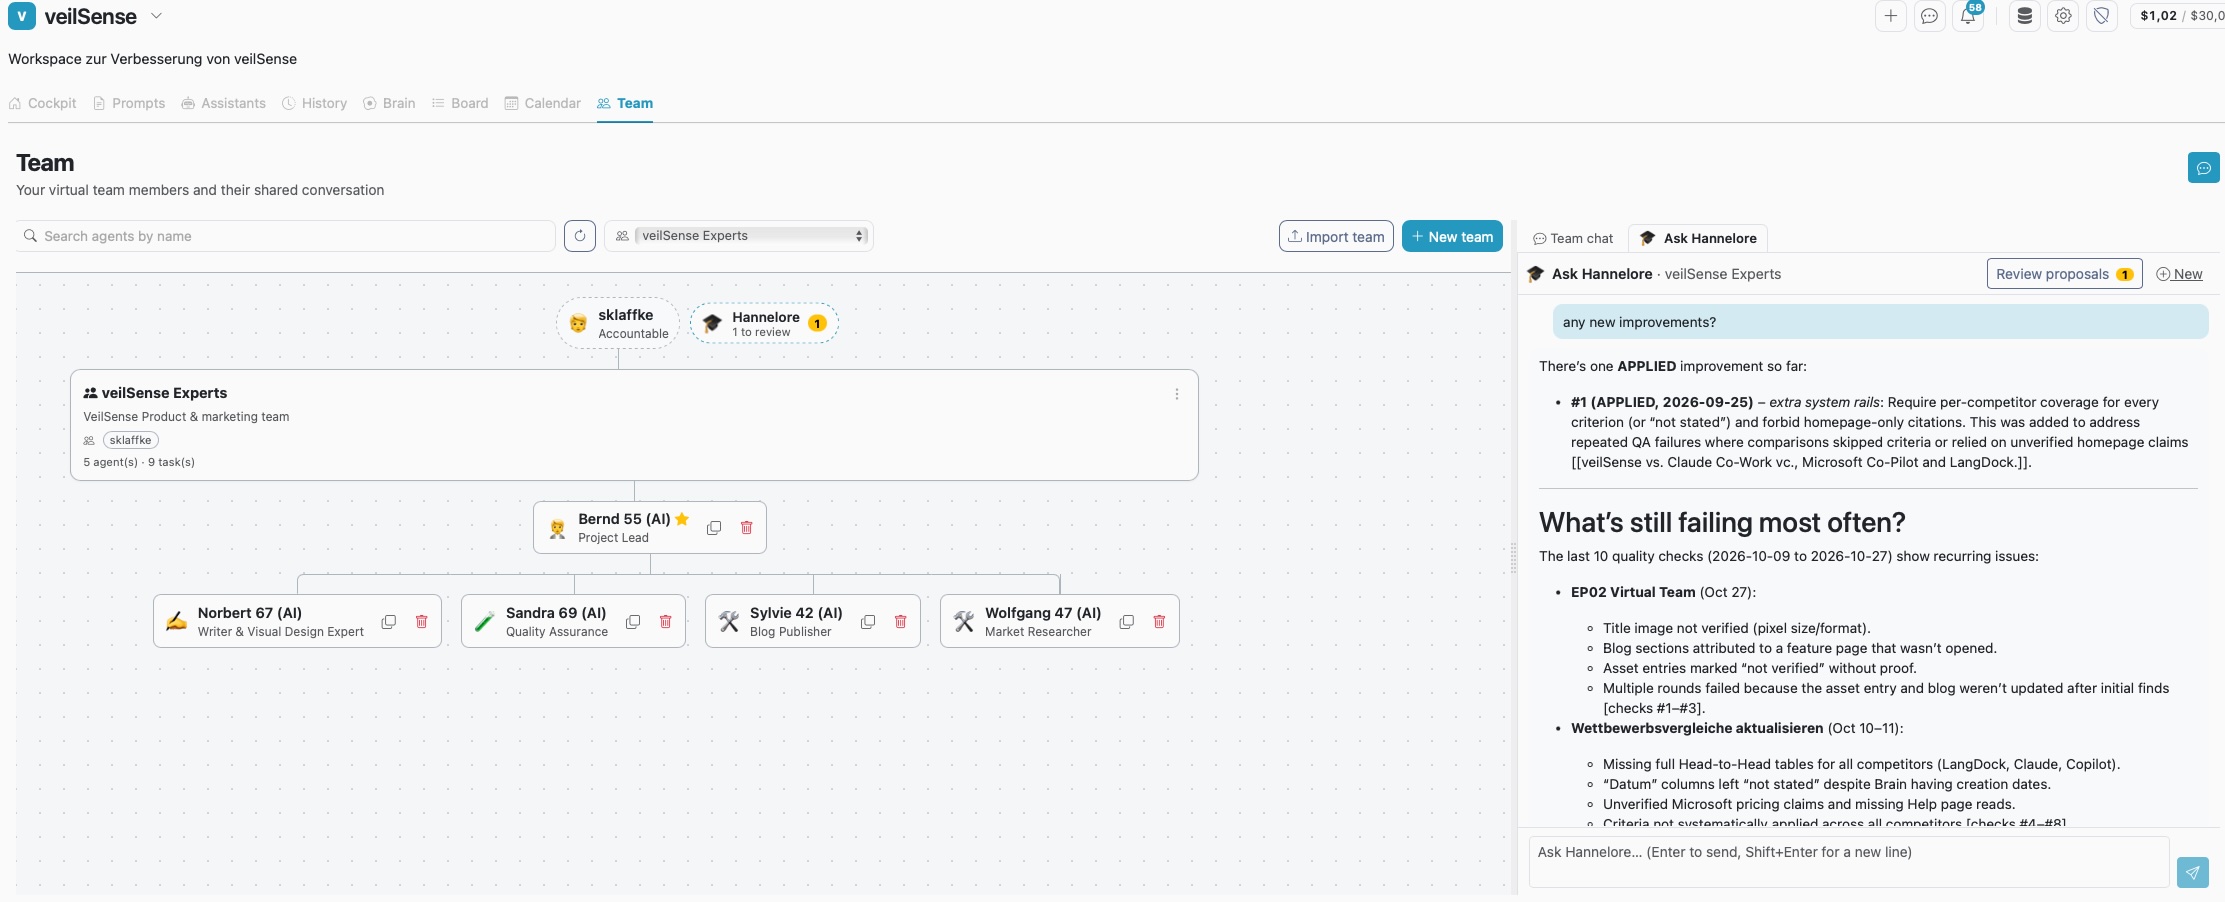
Der Coach beobachtet, wie die Arbeit des Teams geprüft wird, und nutzt diese Historie in zwei Schleifen. Er verbessert die einzelnen Agenten und macht sichtbar, wo die Planung schiefläuft.
- Rücksendungen: Schickt der Mensch im Review-Gate die Arbeit eines Agenten mit „Reject & rework“ zurück, wird das Feedback gesammelt. Optional gibt er eine Ursache an: unklares Briefing, fehlende Fähigkeit, unklare Vorgabe oder anderes.
- Ursache „Bad brief“: Die Rücksendung zählt dann gegen den Lead, nicht gegen den ausführenden Agenten.
- Lead-Qualität: Im Coach-Tab der Team-Einstellungen sieht der Verantwortliche pro Lead die Nacharbeiten der letzten 90 Tage und den Anteil der Briefing-Fehler. Der Tab ist nur für Admins sichtbar und schreibgeschützt.
Wie der Coach eingreift
- Lernschleife für Agenten: Nach mindestens 5 Feedback-Einträgen und 14 Tagen seit der letzten Auswertung schreibt ein Utility-Modell die „Learned notes“ des Agenten neu. Das sind 3 bis 10 dauerhafte Regeln, die bei jeder folgenden Teilaufgabe nach dem System-Prompt eingefügt werden. Manuelles Bearbeiten ist nicht nötig.
- Lead-Regeln brauchen Freigabe: Vorschläge für die Lernnotizen eines Leads werden nie automatisch übernommen. Sie erscheinen im Tab „Behaviour“ unter „New learned notes ready for review“, und der Verantwortliche kann sie übernehmen oder verwerfen.
- Qualitätsanalyse: Der Button „Analyze quality checks“ wertet die Ergebnisse der QA-Prüfungen aus und schlägt Änderungen am System-Prompt oder an den Team-Richtlinien vor. Die Lernschleifen speisen zusätzlich Signale in diese Analyse.
- Kostenbild: Der Coach liest außerdem Durchlaufzeit, Wartezeiten bei Freigaben und Kosten pro Aufgabe. Lange Freigabezeiten sind laut Hilfe ein Prozessthema, kein Prompt-Problem, und der Coach schlägt dafür keine Prompt-Änderung vor.
Warum das wichtig ist: Der Coach lernt aus den Entscheidungen, die ein Mensch am Review-Gate trifft. Er ersetzt die Prüfung nicht. Er sorgt dafür, dass dieselben Fehler nicht immer wieder auftreten, und zeigt, ob das Problem beim Briefing des Leads oder bei der Fähigkeit des Agenten liegt.
Kleine Aufgaben: ein Agent genügt
Für kleine, klar umrissene Aufgaben gibt es den Modus „Run as a single agent“. Der Plan besteht dann aus zwei Schritten: dem Lauf des Agenten und der Freigabe durch eine Person. Es gibt keine Übergaben und keinen eigenen QA-Schritt, die Prüfung liegt allein bei der Person. Für Inhalte, die belegt sein müssen, ist deshalb der Ablauf im Team mit getrenntem QA-Schritt die bessere Wahl. Veröffentlicht wird in beiden Fällen erst nach der Freigabe durch einen Menschen.
Fazit
Das Virtual Team trennt Planung, Ausführung und Entscheidung klar. Agenten übernehmen die Arbeit, der Lead koordiniert, Richtlinien begrenzen, was sie dürfen, und ein Mensch gibt am Ende frei. Im nächsten Teil geht es um Workflows.
Disclaimer: Text und Bilder dieses Beitrags wurden mit Hilfe von KI (veilSense) erzeugt und redaktionell geprüft.

0 Kommentare