EP01: Vom Chat zur Arbeitsplattform: Warum Teams Workspaces statt eines Chatfensters brauchen
Ein Chat-Fenster funktioniert gut, solange eine Person eine Frage stellt. Sobald mehrere Menschen im Team mit Sprachmodellen arbeiten, entstehen Probleme. Kontexte vermischen sich. Gute Prompts liegen in privaten Notizen. Niemand weiß genau, wer welches Modell nutzt und was das kostet. Der Chat ist dafür nicht gebaut.
Der Perspektivwechsel: vom Chat zum Workspace
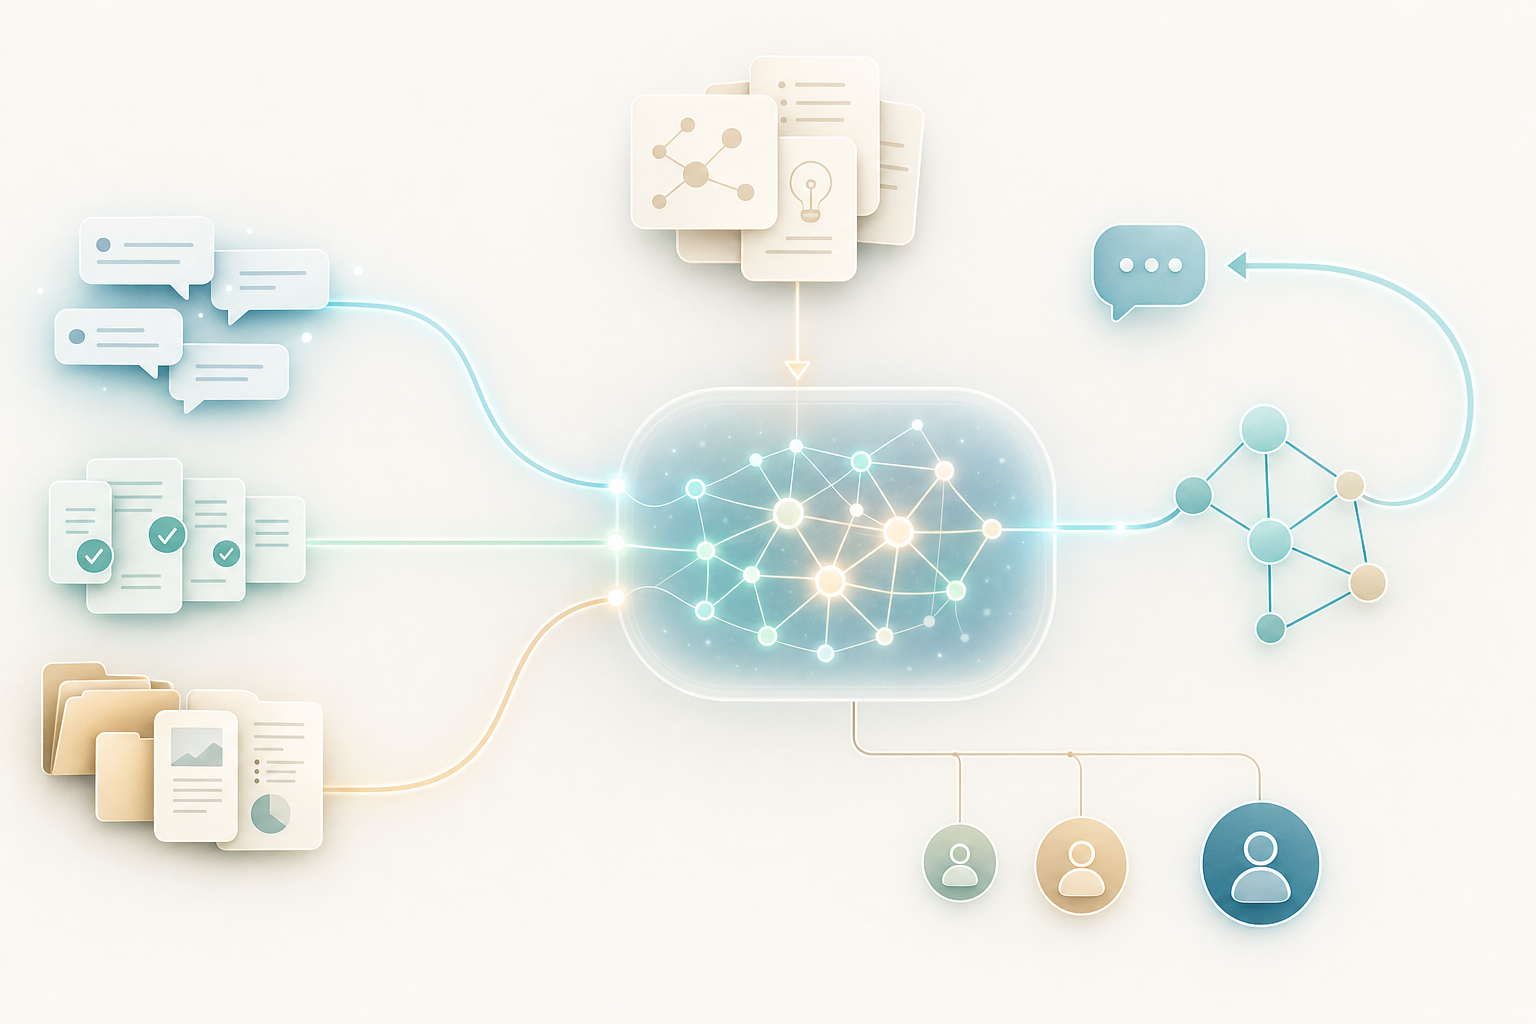
veilSense setzt auf einen anderen Grundgedanken: Workspaces. Ein Workspace ist ein klar abgegrenzter Arbeitsraum. Er legt fest:
- welche LLMs genutzt werden (OpenAI, Anthropic, Gemini oder Ollama),
- wie sensible Daten behandelt werden,
- welche Dokumente, Prompts und Kontexte verfügbar sind,
- welche Nutzer mit welchen Rollen Zugriff haben.
Der Mehrwert liegt also nicht im Chat selbst. Er liegt in Struktur, Kontrolle und Erweiterbarkeit.
Beispiele:
- Unterteilung von Projektarbeit bei unterschiedlichen Kunden in einzelnen Workspaces, um Projektwissen und Geheimnisse zu schützen
- Verschiedene Abteilungen haben unterschiedliche Compliance-/Datenschutzanforderungen und benötigen daher unterschiedliche Einstellungen zu Modellen und Abläufen (Einkauf, HR)
- Gemeinsamer Ablageort für Recherchen
- Matrix Organisation: Ablage von Vorgaben, gemeinsame Prompts, etc.
Struktur: jedes Team und jedes Projekt in seinem Raum
Jedes Team oder Projekt bekommt einen eigenen Bereich mit eigenem Wissen, eigenen Assistenten, eigener History und eigenen Einstellungen. So vermischen sich Kontexte nicht.
- Geteilte Prompt-Vorlagen: Bewährte Prompts gelten workspace-weit. Jede Person im Team nutzt sie, statt sie neu zu erfinden.
- Persistente Threads: Gespräche bleiben erhalten. Man kann sie fortsetzen oder verzweigen.
- Kontext vor der Anfrage: Bevor eine Anfrage an das LLM geht, baut veilSense den passenden Kontext auf, per Graph RAG / RAG und mit klarer Trennung von Themenblöcken und Workspaces.
- Geteiltes Wissen über Workspaces hinaus: Gemeinsames Wissen (General knowledge), das für alle Workspaces gelten soll, kann einmal zentral gepflegt und von allen Workspaces genutzt werden, ohne dass Inhalte kopiert oder doppelt verwaltet werden müssen. Ein Unternehmensbegriff oder eine Richtlinie muss so nur an einer Stelle aktualisiert werden und wirkt sofort überall, wo sie gebraucht wird.
- Workspace Galaxies soll es Teams ermöglichen, über die Grenzen ihres eigenen Workspaces hinaus zu suchen. Die Trennung zwischen Workspaces schützt Kontexte, Einstellungen und Zugriffsrechte, kann aber dazu führen, dass wertvolles Wissen in einem anderen Bereich liegt und unentdeckt bleibt. Eine Suche über mehrere Workspaces hinweg würde dieses Problem lösen, ohne die Trennung aufzugeben. Die Rollen (CONSUMER, CREATOR, ADMIN) pro Workspace und die Berechtigungen bleiben dabei die Grundlage, sodass eine Suche nur Inhalte zutage fördert, auf die die suchende Person ohnehin Zugriff hat. Ein Projektteam könnte etwa eine Produktrecherche durchführen und dabei auf eine Richtlinie oder einen Fachbeitrag aus dem Workspace einer anderen Abteilung zugreifen, ohne dass Inhalte kopiert oder doppelt gepflegt werden müssen. Für das Unternehmen bedeutet das, dass Erkenntnisse nicht in einzelnen Teams verschwinden, sondern über Abteilungsgrenzen hinweg nutzbar werden. Gleichzeitig bleibt jeder Workspace in seinen Einstellungen, Wissensbasen und Zugriffsregeln unabhängig, sodass die bewusste Kontrolle darüber erhalten bleibt, wer was sehen darf.
- Export / Import von Assistenten-Konfigurationen: Assistenten- oder Workflow-Konfigurationen können per Export / Import zwischen den Workspaces ausgetauscht werden, um bspw. eine Präsentation vorzubereiten und anschließend im Zielworkspace weiterzuverwenden. Eine einmal sorgfältig abgestimmte Konfiguration muss so nicht für jedes Team neu aufgebaut werden, und Wissen über gute Abläufe bleibt im Unternehmen verfügbar.
- Brand Kit: ein im System hinterlegtes Corporate Design, das für die gesamte Installation von veilSense gilt. Dadurch sehen Texte, Präsentationen und Vorlagen überall gleich aus, und niemand muss das Layout bei jedem Dokument von Hand nachbauen. Vorlagen, die ihr eigenes Design behalten sollen, lassen sich im Modus „Fill fixed blocks“ davon ausnehmen, sodass bewusst gestaltete Elemente nicht ungewollt überschrieben werden.
So entsteht aus einzelnen Chatverläufen nach und nach ein gemeinsamer Wissensbestand. Er gehört dem gesamten Team und bleibt auch dann erhalten, wenn Mitglieder das Team verlassen oder wechseln. Wertvolles Know-how hängt damit nicht mehr an einzelnen Personen, sondern steht allen Kolleginnen und Kollegen dauerhaft zur Verfügung.
Chat-Threads lassen sich außerdem zusammenfassen oder redaktionell überarbeiten. So wird aus einem flüchtigen Gespräch ein Dokument, das sich weiterverwenden lässt. Eine Recherche aus einem Thread kann als knappe Zusammenfassung in das Brain übernommen werden. Das Ergebnis bleibt dem Team erhalten, auch wenn der ursprüngliche Verlauf inzwischen sehr lang ist oder niemand mehr weiß, wo er liegt. Wer den Verlauf vorher überarbeitet, streicht Umwege und Fehlstarts und behält nur die Schritte, die ein Kollege wirklich braucht. Das spart Zeit und macht den Inhalt für andere schneller verständlich.
Das ist mehr als eine Komfortfunktion. Bei längeren Analysen wächst mit jeder Nachricht der Kontext, den das Modell bei jeder Antwort verarbeiten muss. Eine verdichtete Fassung hält die Arbeit übersichtlich, spart Tokens und macht die Kosten, um die es im nächsten Abschnitt geht, besser planbar.
Kontrolle: wer darf was, und was kostet es?
Rollen. Jeder Workspace kennt drei Stufen: CONSUMER, CREATOR und ADMIN. Ein Admin legt pro Workspace fest, welche Rolle jedes Mitglied hat. Ein CONSUMER liest das Brain, führt Assistenten aus und sieht die eigene History. Ein CREATOR erstellt und bearbeitet zusätzlich Inhalte.
Beispiel aus dem Teamalltag: In einem Marketing-Team erstellt eine erfahrene Kollegin die Vorlage für Pressetexte als CREATOR. Die Kolleginnen und Kollegen im Team nutzen sie als CONSUMER, ohne die Vorlage versehentlich zu verändern. Die Teamleitung als ADMIN entscheidet, wer neu hinzukommt. Dadurch ist klar, wer Inhalte ändert und wer sie nur verwendet.
Budget. Pro Workspace gibt es ein Monatsbudget für den LLM-Verbrauch. Ein Indikator zeigt, wie viel davon bereits verbraucht ist. Ab einer Schwelle (Standard 80 %) erhalten Admins eine Warnung. Wird das Budget überschritten, kommt ebenfalls eine Warnung. Das Budget ist also eine Transparenz- und Warnfunktion und keine harte Obergrenze: Ein Überschreiten stoppt LLM-Aufrufe nicht.
Beispiel aus dem Teamalltag: Ein Projektteam startet einen Workspace für eine Produkt-Recherche. Der Admin sieht im Budget-Indikator, dass in der zweiten Monatshälfte viele lange Analysen laufen. Er erhält die Warnung bei 80 % und kann rechtzeitig reagieren, bevor die Kosten aus dem Ruder laufen.
Nachvollziehbarkeit. Die History hält jede Ausführung mit Zeitstempel, Input, Output, Token-Verbrauch und Kostenschätzung fest. Admins können nach Mitgliedern filtern. Ein Audit-Trail lässt sich als manipulationssicheres, hash-verkettetes Bundle exportieren (veilsense.eu).
Datenschutz: GDPR-ready, pro Workspace steuerbar
Sensible Daten lassen sich vor der Übergabe an externe LLMs anonymisieren, mit firmenspezifischen Dictionaries. Daten im Ruhezustand werden per BYOK (Bring Your Own Key) verschlüsselt. Wer externe Anbieter ganz vermeiden will, kann pro Workspace ein lokales Modell über Ollama wählen.
Ohnehin machen lokale Modelle Sinn, wo ein großes Sprachmodell für den Einsatz überdimensioniert ist oder sensible Dokumente verarbeitet werden sollen. Das betrifft die Extraktion, das Erstellen der Embeddings, Klassifikationen und Fakten-Extraktionen. Gerade bei diesen Schritten bleiben die Dokumente auf der eigenen Infrastruktur, und niemand muss sich fragen, ob Auszüge aus internen Unterlagen bei einem externen Anbieter landen. Hinzu kommt der Aufwand: Ein kleineres lokales Modell antwortet bei einfachen, wiederkehrenden Aufgaben oft schneller und verursacht keine laufenden Token-Kosten. Ein großes Sprachmodell lohnt sich dort, wo wirklich tiefes Verständnis oder komplexe Schlussfolgerungen gefragt sind.
Für das Team bedeutet das eine einfache Entscheidung pro Workspace. Man wählt das Modell nach Aufgabe und Sensibilität der Daten, statt für jeden Schritt dasselbe Modell zu verwenden. So bleibt die Kontrolle dort, wo sie gebraucht wird, und die Kosten bleiben dort, wo sie sinnvoll sind.
Um den Überblick zu behalten, welche Modelle zu welchen Kosten und für welche Zwecke eingesetzt werden, steht Administratoren die Funktion Model Usage Map zur Verfügung. Sie zeigt als Netzwerk die Beziehungen zwischen Quellen, Modellen, Aktionen und Workspaces im Modellkatalog. Damit wird sichtbar, welche Workspaces auf welche Modelle zugreifen und welche Aufgaben dahinterstehen. Gerade wenn mehrere Teams mit unterschiedlichen Modellen arbeiten, verliert man so nicht den Zusammenhang zwischen Einsatz und Ausgaben. Ergänzend lassen sich die Ausgaben nach Modell oder nach Verwendungszweck auswerten, sodass sich erkennen lässt, wo teure Modelle für Aufgaben eingesetzt werden, die auch ein kleineres Modell erledigen könnte. Diese Transparenz ist die Grundlage für bewusste Entscheidungen: Man kann die Modellwahl gezielt an Aufgabe und Sensibilität der Daten ausrichten und die Kosten dort einsetzen, wo sie den größten Nutzen bringen.
Erweiterbarkeit: was noch kommt
Ein Workspace ist die Basis. Darauf bauen weitere Bausteine auf: Virtual Team, Workflows, Kalender und Ontologie. Dazu mehr in den nächsten Episoden dieser Serie.
Einstieg
veilSense läuft per Docker Compose. Kosten entstehen für die eigenen LLM-Anfragen, also für die Tokens der gewählten Anbieter.
Fazit
Ein Chat reicht für Einzelne. Ein Team braucht einen Arbeitsraum mit klaren Grenzen, Rollen und Kostentransparenz. Legen Sie einen ersten Workspace für ein Team oder Projekt an. Den Einstieg finden Sie auf veilsense.eu. In EP02 geht es weiter.
Wie trennen Sie heute Kontexte und Kosten bei KI im Team? Schreiben Sie uns.
Disclaimer: Text und Bilder dieses Beitrags wurden mit Hilfe von KI (veilSense) erzeugt und redaktionell geprüft.
0 Kommentare